Data Engineer Spark & Pyspark - Databricks H/F Celad
- Lyon 7e - 69
- CDI
- Télétravail partiel
- Bac +5
- Secteur informatique • ESN
- Exp. 5 ans
À noter sur ce job
Vous avez ces compétences ? Cliquez dessus pour les ajouter rapidement à votre profil !
Les missions du poste
A LIRE ATTENTIVEMENT AVANT DE POSTULER ⬇
🏠 2 à 3 jours de télétravail / semaine - 📍 Lyon (07) - 🛠 Expérience de 5 ans minimum
Vous aimez travailler sur toute la chaîne de traitement de la donnée, de la compréhension des besoins métier jusqu'à sa restitution ?
Nous recherchons actuellement un.e Data Engineer Spark & PySpark / Databricks pour rejoindre l'équipe Data/BI de l'un de nos clients.
Votre mission : faire évoluer l'architecture décisionnelle existante, développer et optimiser les traitements de données et participer à une migration vers Databricks.
Un poste qui combine développement, modélisation de données et échanges avec les équipes métier.
Votre mission : faire évoluer la plateforme Data
Vous interviendrez sur les différentes étapes de la chaîne décisionnelle, depuis l'identification des données jusqu'à leur exploitation pour le reporting métier.
Concrètement, vous serez amené à :
- Comprendre les besoins métier : échanger avec les interlocuteurs métier, analyser leurs attentes et identifier les données nécessaires.
- Concevoir et faire évoluer les modèles de données : enrichir les entrepôts de données et les datamarts pour répondre aux besoins de reporting.
- Développer les traitements Data : concevoir des pipelines d'intégration et des traitements Spark pour transformer et préparer les données.
- Améliorer la qualité et les performances : contrôler, nettoyer les données et optimiser les traitements existants.
- Participer à la migration vers Databricks : contribuer à l'évolution de l'architecture et des traitements dans le cadre de cette migration.
- Assurer la fiabilité des développements : réaliser les tests, documenter les solutions, participer aux déploiements et assurer la maintenance.
Le profil recherché
Votre environnement technique :
Vous évoluerez dans un environnement associant technologies Big Data, bases de données et outils décisionnels.
La stack de l'équipe :
- Traitement des données : Apache Spark, Databricks, PySpark
- Bases de données et stockage : Oracle, S3, Parquet
- Intégration et reporting : Informatica, Tableau
- Gestion de code et déploiement : Git, Jenkins
Ce qui fera la différence
Vous avez déjà une expérience en BI ou en Data Engineering et vous souhaitez intervenir aussi bien sur la construction des traitements que sur l'évolution d'une architecture décisionnelle.
Pour être à l'aise sur cette mission :
- Spark & PySpark sont indispensables : vous savez les utiliser pour développer et optimiser des traitements de données.
- Vous avez une très bonne maîtrise de SQL, notamment pour manipuler, transformer et exploiter les données.
- Vous avez une expérience en modélisation de données, utile pour concevoir et faire évoluer les entrepôts de données et les datamarts.
- Vous êtes capable de comprendre les besoins métier et de les traduire en solutions techniques adaptées.
Une connaissance de Python et/ou Java sera appréciée.
Au-delà des compétences techniques, nous recherchons une personne rigoureuse, autonome et à l'aise dans les échanges avec les équipes métier.
Si vous êtes prêt.e à relever ce défi et à contribuer à des projets stimulants, n'hésitez pas à postuler dès maintenant ! 🚀
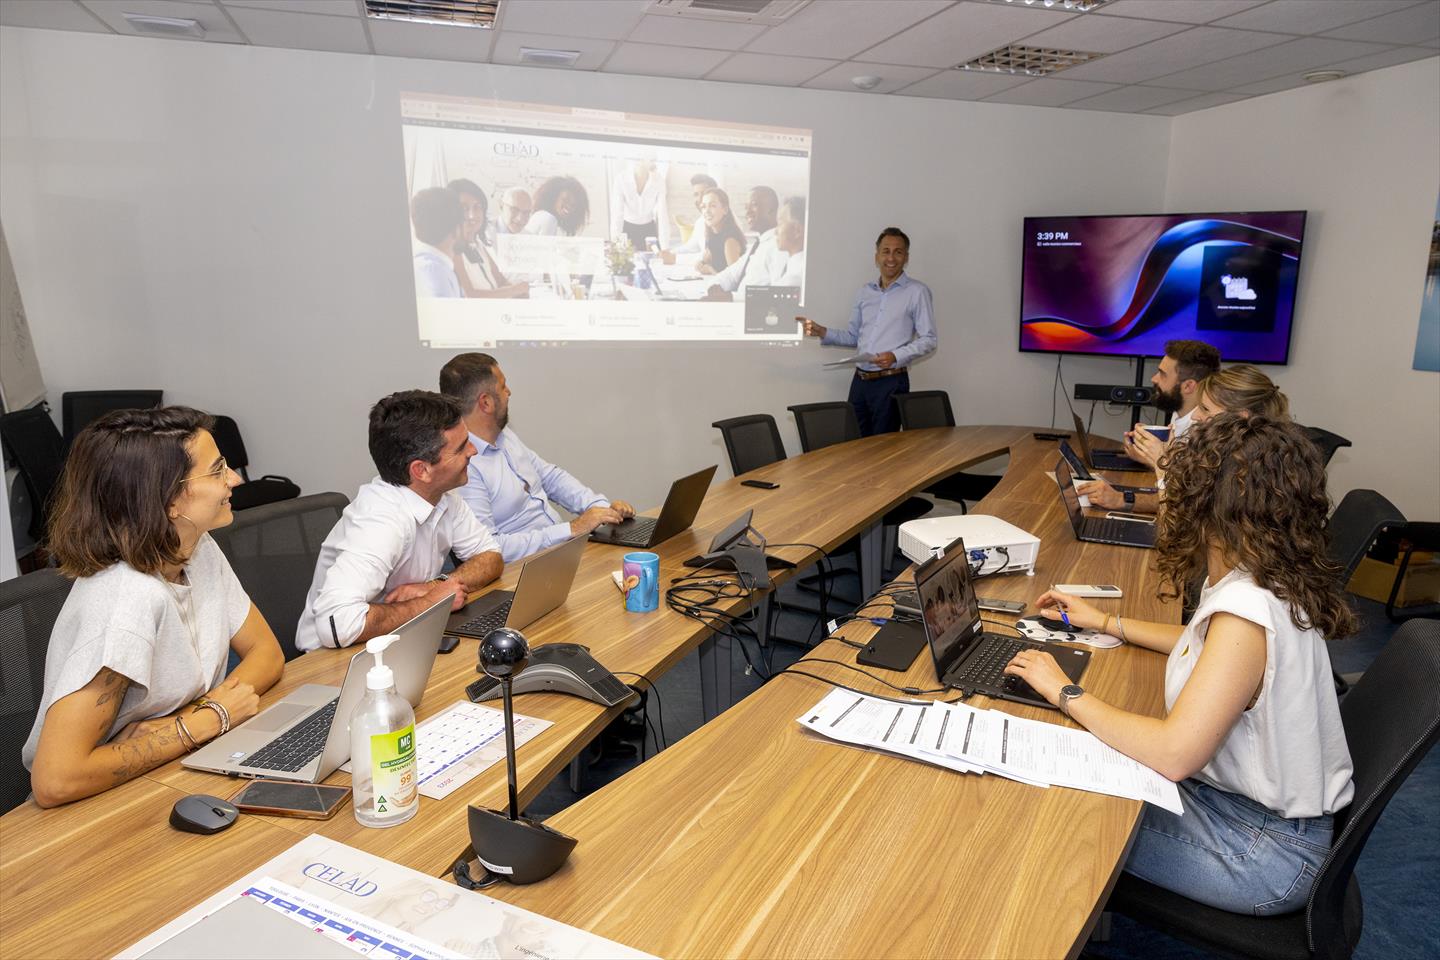
Celad en images
Publiée le 26/10/2026 - Réf : 4422113/30688191 DESPDF/69L